
译者:沙托萨兰县廉洁 孟祥伟
强化也并非十分困难的,要随著情形的出现改变展开适当的修正。当资料库内部结构设计出现出现改变,主要包括更动表内部结构:表头和检索的减少、删掉或更名等;销售业务方法论出现出现改变:如查阅形式、值域覆盖范围出现出现改变之类。许多强化从许多工程项目中抽取出的实战经验,这两点至关重要。
一、 防止对列的操作形式
任何人对列的操作形式都可能将引致全表扫描器,这儿简而言之的操作形式主要包括资料库函数、排序函数之类,查阅时要尽量将操作形式移往式子的左边,即使拿掉函数。
例1:以下SQL前提句子中的列都筑有正确的检索,但30圆觉统计数据情形下继续执行速率却十分慢:
select * from record where substrb(CardNo,1,4)=5378(13秒)
select * from record where amount/30< 1000(11秒)
select * from record where to_char(ActionTime,yyyymmdd)=19991201(10秒)
虽然where从句中对列的任何人操作形式结论都是在SQL运转时由上而下排序获得的,因而它不得已展开表扫描器,而没采用该列下面的检索;假如那些结论在查阅校对时就能获得,所以就能被SQL强化器强化,采用检索,防止表扫描器,因而将SQL改写如下表所示:
select * from record where CardNo like 5378%(< 1秒)
select * from record where amount < 1000*30(< 1秒)
select * from record where ActionTime= to_date (19991201 ,yyyymmdd)(< 1秒)
差别是很明显的!
二、 防止不必要的类型转换
需要注意的是,尽量防止潜在的统计数据类型转换。如将字符型统计数据与数值型统计数据比较,ORACLE会自动将字符型用to_number()函数展开转换,从而引致全表扫描器。
例2:表tab1中的列col1是字符型(char),则以下句子存在类型转换:
select col1,col2 from tab1 where col1>10,
应该写为: select col1,col2 from tab1 where col1>10。
三、 减少查阅的覆盖范围限制
减少查阅的覆盖范围限制,防止全覆盖范围的搜索。
例3:以下查阅表record 中时间ActionTime小于2001年3月1日的统计数据:
select * from record where ActionTime < to_date (20010301 ,yyyymm)
查阅计划表明,下面的查阅对表展开全表扫描器,假如我们知道表中的最早的统计数据为2001年1月1日,所以,能减少一个最小时间,使查阅在一个完整的覆盖范围之内。修改如下表所示: select * from record where
ActionTime < to_date (20010301 ,yyyymm)
and ActionTime > to_date (20010101 ,yyyymm)
后一种SQL句子将利用上ActionTime表头上的检索,从而提高查阅效率。把20010301换成一个变量,根据值域的机率,能有一半以上的机会提高效率。同理,对于大于某个值的查阅,假如知道当前可能将的最大值,也能在Where从句中加上 AND 列名< MAX(最大值)。
四、 尽量拿掉"IN"、"OR"
含有"IN"、"OR"的Where从句常会采用工作表,使检索失效;假如不产生大量重复值,能考虑把从句拆开;拆开的从句中应该包含检索。
例4:select count(*) from stuff where id_no in(0,1)(23秒)
能考虑将or从句分开:
select count(*) from stuff where id_no=0
select count(*) from stuff where id_no=1
然后再做一个简单的加法,与原来的SQL句子相比,查阅速率更快。
五、 尽量拿掉 "<>"
尽量拿掉 "<>",防止全表扫描器,假如统计数据是枚举值,且值域覆盖范围固定,则修改为"OR"形式。
例5:UPDATE SERVICEINFO SET STATE=0 WHERE STATE<>0;
以上句子虽然其中包含了"<>",继续执行计划中用了全表扫描器(TABLE ACCESS FULL),没用到state表头上的检索。实际应用中,虽然销售业务方法论的限制,表头state为枚举值,只能等于0,1或2,而且,值等于=1,2的很少,因而能拿掉"<>",利用检索来提高效率。
修改为:UPDATE SERVICEINFO SET STATE=0 WHERE STATE = 1 OR STATE = 2 。进一步的修改能参考第4种方法。
六、 拿掉Where从句中的IS NULL和IS NOT NULL
Where字句中的IS NULL和IS NOT NULL将不会采用检索而是展开全表搜索,因而需要通过出现改变查阅形式,分情形讨论等方法,拿掉Where从句中的IS NULL和IS NOT NULL。
七、 检索提高统计数据分布不均匀时查阅效率
检索的选择性低,但统计数据的值分布差异很大时,仍然能利用检索提高效率。A、统计数据分布不均匀的特殊情形下,选择性不高的检索也要创建。
表ServiceInfo中统计数据量很大,假设有一百圆觉,其中有一个表头DisposalCourseFlag,值域覆盖范围为枚举值:[0,1,2,3,4,5,6,7]。按照前面说的检索建立的规则,选择性不高的表头不应该建立检索,该表头只有8种值域,检索值的重复率很高,检索选择性明显很低,因而不建检索。然而,虽然该表头上统计数据值的分布情形十分特殊,具体如下表所示表:
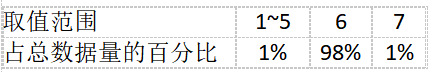
而且,常用的查阅中,查阅DisposalCourseFlag<6 的情形既多又频繁,毫无疑问,假如能够建立检索,并且被应用,所以将大大提高这种情形的查阅效率。因而,我们需要在该表头上建立检索。
八、 利用HINT强制指定检索
在ORACLE强化器无法用上合理检索的情形下,利用HINT强制指定检索。
继续下面7的例子,ORACLE缺省认定,表中列的值是在所有统计数据行中均匀分布的,也就是说,在一百万统计数据量下,每种DisposalCourseFlag值各有12.5万统计数据行与之对应。假设SQL搜索前提DisposalCourseFlag=2,利用DisposalCourseFlag列上的检索展开统计数据搜索效率,往往不比全表扫描器的高,ORACLE因而对检索视而不见,从而在查阅路径的选择中,用其他表头上的检索即使全表扫描器。根据我们下面的分析,统计数据值的分布很特殊,严重的不均匀。为了利用检索提高效率,此时,一方面能单独对该表头或该表用analyze句子展开分析,对该列搜集足够的统计统计数据,使ORACLE在查阅选择性较高的值时能用上检索;另一方面,能利用HINT提示,在SELECT关键字后面,加上的形式,强制ORACLE强化器用上该检索。
比如: select * from serviceinfo where DisposalCourseFlag=1 ;
下面的句子,实际继续执行中ORACLE用了全表扫描器,加上蓝色提示部分后,用到检索查阅。如下表所示:
select *
from serviceinfo where DisposalCourseFlag=1;
请注意,这种方法会加大代码维护的难度,而且该表头上检索的名称被出现改变之后,要要同步所有指定检索的HINT代码,否则HINT提示将被ORACLE忽略掉。
九、 屏蔽无用检索
继续下面8的例子,虽然实际查阅中,还有涉及到DisposalCourseFlag=6的查阅,而此时假如用上该表头上的检索,将是十分不明智的,效率也极低。因而这种情形下,我们需要用特殊的方法屏蔽该检索,以便ORACLE选择其他表头上的检索。
比如,假如表头为数值型的就在函数的表头名后,添加+ 0,为字符型的就并上空串:||""
如: select * from serviceinfo where DisposalCourseFlag+ 0 = 6 and workNo = 36 。
不过,不要把该用的检索屏蔽掉了,否则同样会产生低效率的全表扫描器。
十、 分解复杂查阅,用常量代替变量
对于复杂的Where前提组合,Where中含有多个带检索的表头,考虑用IF句子分情形展开讨论;同时,拿掉不必要的外来参数前提,减低复杂度,以便在不同情形下用不同表头上的检索。
继续下面9的例子,对于包含
Where (DisposalCourseFlag < v_DisPosalCourseFlag) or (v_DisPosalCourseFlag is null) and ....的查阅,(这儿v_DisPosalCourseFlag为一个输入变量,值域覆盖范围可能将为[NULL,0,1,2,3,4,5,6,7]),能考虑分情形用IF句子展开讨论,类似:
IF v_DisPosalCourseFlag =1 THEN
Where DisposalCourseFlag = 1 and ....
ELSIF v_DisPosalCourseFlag =2 THEN
Where DisposalCourseFlag = 2 and ....
。。。。。。
十一、 like从句尽量前端匹配
因为like参数采用的十分频繁,因而假如能够对like从句采用检索,将很高的提高查阅的效率。
例6:select * from city where name like ‘%S%’
以上查阅的继续执行计划用了全表扫描器(TABLE ACCESS FULL),假如能够修改为:
select * from city where name like ‘S%’
所以查阅的继续执行计划将会变成(INDEX RANGE SCAN),成功的利用了name表头的检索。这意味着Oracle SQL强化器会识别出用于检索的like从句,只要该查阅的匹配端是具体值。因而我们在做like查阅时,应该尽量使查阅的匹配端是具体值,即采用like ‘S%’。
十二、 用Case句子合并多重扫描器
我们常常要基于多组统计数据表排序不同的聚集。例如下表所示例通过三个独立查阅:
例7:
1)select count(*) from emp where sal<1000;
2)select count(*) from emp where sal between 1000 and 5000;
3)select count(*) from emp where sal>5000;
这样我们需要展开三次全表查阅,但是假如我们采用case句子:
select
count (sale when sal <1000
then 1 else null end) count_poor,
count (sale when between 1000 and 5000
then 1 else null end) count_blue_collar,
count (sale when sal >5000
then 1 else null end) count_poor
from emp;
这样查阅的结论一样,但是继续执行计划只展开了一次全表查阅。
十三、 采用nls_date_format
例8:
select * from record where to_char(ActionTime,mm)=12
这个查阅的继续执行计划将是全表查阅,假如我们出现改变nls_date_format,
SQL>alert session set nls_date_formate=’MM’;
现在重新修改下面的查阅:
select * from record where ActionTime=12
这样就能采用actiontime上的检索了,它的继续执行计划将是(INDEX RANGE SCAN)。
十四、 采用基于函数的检索
前面谈到任何人对列的操作形式都可能将引致全表扫描器,例如:
select * from emp where substr(ename,1,2)=’SM’;
但是这种查阅在客服系统又经常采用,我们能创建一个带有substr函数的基于函数的检索,
create index emp_ename_substr on eemp ( substr(ename,1,2) );
这样在继续执行下面的查阅句子时,这个基于函数的检索将派上用场,继续执行计划将是(INDEX RANGE SCAN)。
十五、 基于函数的检索要求式子匹配
下面的例子中,我们创建了基于函数的检索,但是假如继续执行下面的查阅:
select * from emp where substr(ename,1,1)=’S’
获得的继续执行计划将还是(TABLE ACCESS FULL),因为只有当统计数据列能够式子匹配时,基于函数的检索才能生效,这样对于这种检索的计划和维护的要求都很高。请注意,向表中添加检索是十分危险的操作形式,因为这将引致许多查阅继续执行计划的变更。然而,假如我们采用基于函数的检索就不会产生这样的问题,因为Oracle只有在查阅采用了匹配的内置函数时才会采用这种类型的检索。
十六、 采用分区检索
在用分析命令对分区检索展开分析时,每一个分区的统计数据值的覆盖范围信息会放入Oracle的统计数据字典中。Oracle能利用这个信息来抽取出那些只与SQL查阅相关的统计数据分区。
例如,假设你已经定义了一个分区检索,并且某个SQL句子需要在一个检索分区中展开一次检索扫描器。Oracle会仅仅访问这个检索分区,而且会在这个分区上调用一个此检索覆盖范围的快速全扫描器。因为不需要访问整个检索,所以提高了查阅的速率。
十七、 采用位图检索
位图检索能从本质上提高采用了小于1000个唯一统计数据值的统计数据列的查阅速率,因为在位图检索中展开的检索是在RAM中完成的,而且也总是比传统的B树检索的速率要快。对于那些少于1000个唯一统计数据值的统计数据列建立位图检索,能使继续执行效率更快。
十八、 决定采用全表扫描器还是采用检索
和所有的秘笈一样,最后一招都会又回到起点,最后我们来讨论一下是否需要建立检索,也许展开全表扫描器更快。在大多数情形下,全表扫描器可能将会引致更多的物理磁盘输入输出,但是全表扫描器有时有可能将会因为高度并行化的存在而继续执行的更快。假如查阅的表完全没顺序,所以一个要返回记录数小于10%的查阅可能将会读取表中大部分的统计数据块,这样采用检索会使查阅效率提高许多。但是假如表十分有顺序,所以假如查阅的记录数大于40%时,可能将采用全表扫描器更快。因而,有一个检索覆盖范围扫描器的总体原则是:
1)对于原始排序的表 仅读取少于表记录数40%的查阅应该采用检索覆盖范围扫描器。反之,读取记录数目多于表记录数的40%的查阅应该采用全表扫描器。
2)对于未排序的表 仅读取少于表记录数7%的查阅应该采用检索覆盖范围扫描器。反之,读取记录数目多于表记录数的7%的查阅应该采用全表扫描器。
总结
以上的招式,是完全能相互结合同时运用的。而且各种方法之间相互影响,紧密联系。这种联系既存在一致性,也可能将带来冲突,当冲突出现时,需要根据实际情形展开选择,没固定的模式。最后决定SQL强化功力的因素就是对ORACLE内功的掌握程度了。
另外,值得注意的是:随著时间的推移和统计数据的累计与变化,ORACLE对SQL句子的继续执行计划也会出现改变,比如:基于代价的强化方法,随著统计数据量的增大,强化器可能将错误的不选择检索而采用全表扫描器。这种情形可能将是因为统计信息已经过时,在统计数据量变化很大后没及时分析表;但假如对表展开分析之后,仍然没用上合理的检索,所以就有必要对SQL句子用HINT提示,强制用合理的检索。但这种HINT提示也不能滥用,因为这种方法过于复杂,缺乏通用性和应变能力,同时也减少了维护上的代价;相对来说,基于函数右移、拿掉IN ,OR ,<> ,IS NOT NULL 、分解复杂的SQL句子之类方法,却是放之四海皆准的,能放心大胆的采用。
同时,强化也并非十分困难的,要随著情形的出现改变展开适当的修正。当资料库内部结构设计出现出现改变,主要包括更动表内部结构:表头和检索的减少、删掉或更名等;销售业务方法论出现出现改变:如查阅形式、值域覆盖范围出现出现改变之类。
